
Som du sikkert vet, behandler CPU-en programvare for å få alt til å fungere i et datasystem. Programmer består av instruksjoner og data; instruksjonene forteller deg hvilken operasjon du skal utføre på dataene for å få det forventede resultatet. Og det er slik alt fungerer. Vel, en av de viktigste enhetene i CPU-en er ALU eller FPU, som er ansvarlig for matematiske operasjoner. Og i moderne prosessorer, som Intel-prosessorer, er funksjonelle enheter som er i stand til å utføre vektorinstruksjoner med datalengder på opptil 512 bits inkludert, for eksempel AVX-512, som vi skal diskutere her.
Disse utvidelsene har som mål å akselerere behandlingen av visse arbeidsmengder, spesielt vitenskapelige, som krever et stort antall slike operasjoner. Da AVX-512 dukket opp, ble den imidlertid ikke godt mottatt av Intel ; mange mislikte dette tillegget og møtte til og med noen problemer, som vi skal se ...
Du kan også være interessert i:
Hvordan fungerer en ALU?
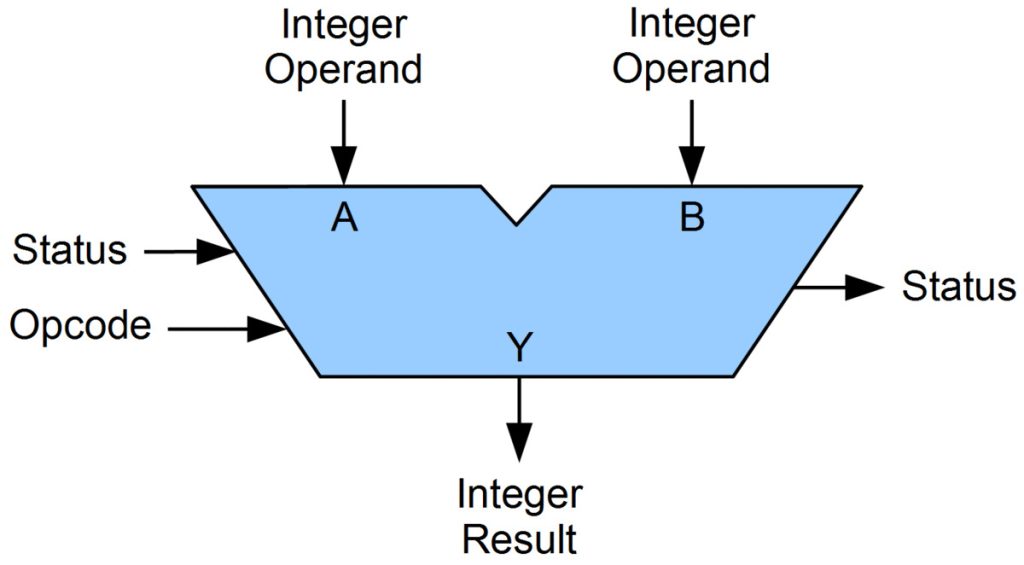
Før vi lærer mer om instruksjonssettet AVX-512, er det viktig å først forstå hvordan en ALU (aritmetisk-logisk enhet) fungerer , det vil si en aritmetisk og logisk prosesseringsenhet.
Med andre ord utfører denne enheten beregninger som inkluderer operasjoner som addisjon, multiplikasjon, divisjon osv. For å utføre disse oppgavene bruker ALU-en spesifikke digitale kretser styrt av CPU-ens kontrollenhet. Når kontrollenheten henter en instruksjon som skal behandles fra minnet og dekoder den, sender den en opkode til ALU-en som forteller den hva den skal gjøre med to databiter som skal lastes inn i registrene. For eksempel vil en ADD-instruksjon addere, en SUB-instruksjon subtrahere, en MUL-instruksjon multiplisere, en DIV-instruksjon dividere og så videre.
Videre vil denne ALU-en, i likhet med resten av CPU-enhetene, operere med en hastighet bestemt av klokkefrekvensen. Hvis den for eksempel er 5 GHz, vil den enkelt sagt utføre 5.000 milliarder operasjoner per sekund.
Når det er sagt, øker også mengden varme som genereres av CPU-en, når CPU-klokkehastigheten øker. Derfor er det ikke bare å øke frekvensen den eneste løsningen for å oppnå bedre ytelse. Av denne grunn må CPU-designere se etter alternative ytelsesforbedringer, som parallellisme på kjernenivå, registerendring, prediksjon og spekulasjon, utførelse i feil rekkefølge, superskalarsystemer og så videre. Blant tiltakene for å øke datakraften er bruken av SIMD-instruksjoner , eller vektorinstruksjoner, som er i stand til å operere på større datasett.
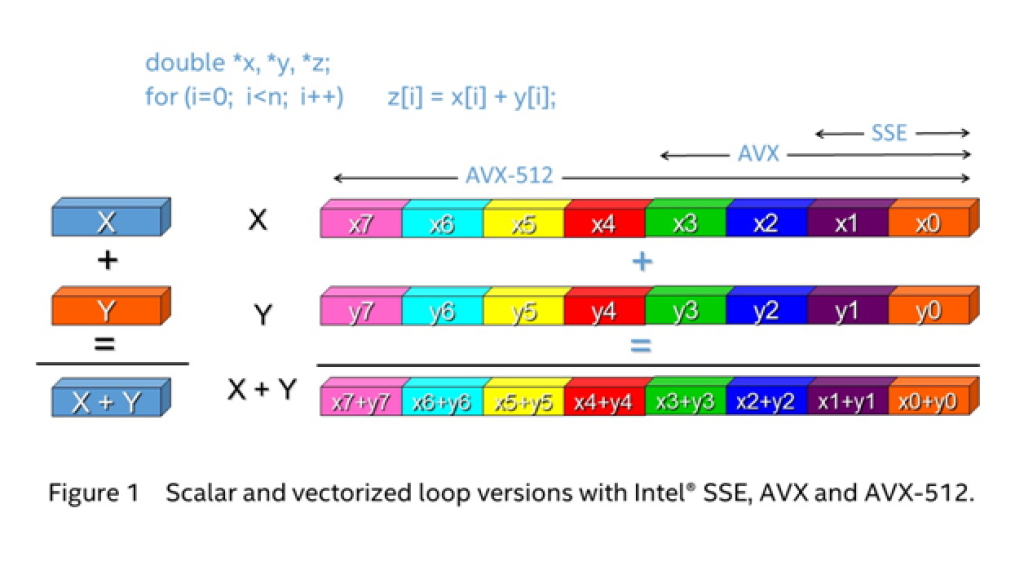
Et eksempel på disse instruksjonene er AVX-512 . Mens andre enheter fungerer med 64-bits data, fungerer spesialenhetene for disse utvidelsene med 512-bits data, noe som betyr at de kan håndtere 8 ganger den normale ordstørrelsen samtidig. For å gjøre dette trengs større og mer komplekse ALU-er (for heltall) eller FPU-er (for flyttalloperasjoner) , noe som betyr et større brikkefotavtrykk, dermed høyere kostnader og andre komplikasjoner.
Hvordan kommer dataene til ALU-en?
Nå som du har en grunnleggende forståelse av hva en ALU er og hvordan den fungerer, samt hva AVX-512-er brukes til på et grunnleggende nivå, er neste trinn å lære hvordan data når ALU-en , da dette også vil hjelpe deg å forstå disse utvidelsene.
For å nå ALU-en må dataene bevege seg gjennom forskjellige lagringssystemer. Denne datareisen er basert på datasystemets minnehierarki . En kort beskrivelse av dette hierarkiet ville være:
- Sekundærminne: Dette er masselagringsmedier, det vil si HDD- eller SSD-harddisker, blant andre disker som også kan være koblet til I/O-systemet, for eksempel optiske medier osv. De lagrer en stor mengde informasjon, men minnet deres er tregere sammenlignet med CPU-hastigheten. Derfor medfører tilgang til disse mediene en straff, større latens. For å unngå disse straffene laster vi disse dataene inn i et primært minne, som vi skal diskutere i neste punkt. For eksempel, for å gi deg en klarere idé, tenk deg at du har Word installert på harddisken din, og du vil kjøre det. Denne programvaren vil bestå av en serie kjørbare filer eller binærfiler som inneholder instruksjonene og dataene som er nødvendige for at CPU-en skal kunne kjøre dem. Det kan også hende at programvaren du vil kjøre ikke er på en harddisk, for eksempel når du installerer et operativsystem fra en USB-minnepinne eller DVD. De kjørbare binærfilene med disse instruksjonene og dataene vil også bli funnet der.
- Primærminne: Det primære lagringssystemet består av RAM (random access memory). Dette lagringssystemet er raskere enn det sekundære lagringssystemet, men det kan ikke lagre like mye informasjon, og det kan heller ikke gjøre det permanent, siden det er et flyktig minne som lagrer informasjon mens det er slått på. Det vil si at hver gang du slår av datamaskinen, slettes ikke programmene du har installert, men innholdet i denne RAM-en. Som sagt, når prosessen eller programmet lastes inn i RAM-en, overføres instruksjonene og dataene fra den kjørbare binærfilen fra den sekundære enheten til denne primære enheten, som CPU-en kan få tilgang til raskere.
- Cache: Hurtigbufferen er innebygd i CPU-en og er det raskeste minnesystemet, men den har også en veldig liten kapasitet og er ustabil. Dette minnesystemet er vanligvis delt inn i tre deler: L1, L2 og L3. Alle data som må behandles av ALU-en flyttes fra harddisken til RAM og deretter til hurtigbufferen. Når det er sagt, kan ikke ALU-en få tilgang til data direkte fra hurtigbufferen. Derfor trenger den et annet, enda mindre og raskere minne, som er neste punkt...
- CPU-registre: CPU-registeret er et veldig enkelt minne som består av veldig raske flip-flop-elementer. Avhengig av CPU-arkitekturen kan registrene endre størrelse. For eksempel kan de være 8-bit, 16-bit, 32-bit, 64-bit, osv. Videre kan antallet deres være variabelt, og alle utgjør CPU-ens registervindu eller fil. Det er i disse registrene at dataenheter, som ALU eller FPU, kan få tilgang til dataene som er lastet inn i dem. Så når en instruksjon hentes fra RAM til CPU i hentesyklusen, vil instruksjonen bli dekodet eller tolket av kontrollenheten, som vil bestemme hva utførelsen av den instruksjonen innebærer. For eksempel kan ADD r1, r2, r3 legge sammen dataene i register r2 + r3 og lagre resultatet i r1. På denne måten vil kontrollenheten sende denne opkoden til ALU, og be den om å legge sammen verdiene og plasseringen av dataene, i dette tilfellet de nødvendige registrene. ALU får deretter tilgang til dataene og utfører addisjonsoperasjonen. Slik fungerer dette hierarkiet.
Videre, som du sikkert vet, lagres de mest brukte dataene og instruksjonene i hurtigbufferen, noe som gir raskere tilgang ved behov i fremtiden. Som du kanskje forventer, er hvert hurtigbuffernivå raskere:
- L1Dette er det første nivået, det raskeste av alle, med den laveste latensen. Dette betyr at færre klokkesykluser går tapt når man aksesserer det. Videre er dette minnet vanligvis delt inn i en L1D eller L1 for data, og en L1I eller L1 for instruksjoner. Dette betyr at instruksjoner og data ikke blandes.
- L2Dette er neste nivå av hurtigbuffer, og har større kapasitet enn L1, men er noe tregere, så det kreves flere sykluser for å få tilgang til den. Her vil både data og instruksjoner blandes, siden den er enhetlig.
- L3Dette nivået har større kapasitet enn L2, men er enda tregere enn L2. Og i likhet med L2 er det også enhetlig, og lagrer både data og instruksjoner. Hvis L3 er det siste nivået, er det også kjent som LLC (Last Level Cache), selv om andre systemer kan ha andre nivåer, for eksempel L4, osv.
Som du kan tenke deg, når CPU-en trenger å søke etter data eller instruksjoner for å øke ytelsen, vil den først søke i L1, siden den krever færrest klokkesykluser for tilgang. Hvis den ikke er der, vil den søke i L2, den nest raskeste. Og hvis den heller ikke er der, vil den søke i L3. Hvis den heller ikke er der, vil den søke i RAM, og så videre.
Hva er AVX-512 og hvordan fungerer det?
Instruksjonssettet AVX-512 er den andre iterasjonen av AVX og kom til Intel-prosessorer i 2013. AVX står for Advanced Vector Extensions, og ble først introdusert i Intels Xeon Phi (Knights Landing)-prosessorer og kom senere til Intels serverprosessorer med de Skylake-X-baserte Xeon-prosessorene.
Videre nådde AVX-512-instruksjonssettet også forbrukerdatamaskiner, dvs. PC-er, med Cannon Lake-arkitekturen og ble senere kompatibelt med Ice Lake- og Tiger Lake-arkitekturene. Dette var kanskje et av de mest kritiserte tiltakene, et som aldri burde ha blitt tatt, delvis fordi det ikke fantes nok programvare som kunne dra nytte av disse instruksjonene, og delvis fordi det gjorde disse systemene mer komplekse.
Som forklart tidligere, kan ALU/FPU bare få tilgang til dataene som finnes i en CPUs register . AVX-instruksjonssettet øker størrelsen på disse registrene. På grunn av denne økningen kan flere dataelementer behandles med én enkelt instruksjon, noe som forbedrer ytelsen.
Hovedmålet med dette instruksjonssettet var å akselerere oppgaver relatert til datakomprimering, bildebehandling og kryptografiske beregninger . Ved å tilby dobbelt så mye datakraft sammenlignet med AVX-256, ga instruksjonssettet AVX-512 betydelige ytelsesforbedringer. Det doblet imidlertid ikke ytelsen til disse Intel-CPU-ene, slik mange kanskje antar.
Hvorfor avvikler Intel AVX-512?
Som forklart tidligere, tilbyr instruksjonssettet AVX-512 flere fordeler i beregningsmessige beregninger, men ikke alle var velkomne . Det er sant at populære biblioteker som TensorFlow bruker instruksjonssettet til å gi raskere beregninger på CPUer som støtter det.
AMD tok først i bruk AVX-512 i Zen 4-baserte mikroprosessorer. Et fullstendig skifte mellom de to selskapene ...
Så hvorfor deaktiverer Intel AVX-512 i sine nyere Alder Lake-prosessorer? Sannheten er at den ikke har blitt fjernet helt. For eksempel har Alder Lake -prosessorer en heterogen flerkjernearkitektur, med høytytende P-kjerner og høyeffektive E-kjerner.
Mens P-kjerner er basert på Golden Cove-mikroarkitekturen og kan utføre disse instruksjonene, kan ikke E-kjerner, basert på Gracemont-mikroarkitekturen . Planleggeren for disse kjernene avviser slike instruksjoner for å holde dem mindre og mer energieffektive.
I motsetning til dette er ikke Alder Lake-CPUer og senere kompatible med AVX-512-instruksjonssettet, da dette ville forhindre at visse programmer kjører på E-kjernene. De kan imidlertid brukes på andre CPUer der Intel ikke har fysisk integrert disse kjernene, for eksempel Xeon-prosessorer for HPC og servere, og til og med på noen systemer der E-kjerner kan deaktiveres via BIOS/UEFI.
Trenger man AVX-512 på en forbruker-CPU?
AVX-512-instruksjonssettet øker størrelsen på en CPUs register for å forbedre ytelsen. Denne ytelsesøkningen lar CPU-er behandle tall raskere, slik at brukere kan kjøre video-/lydkomprimeringsalgoritmer med høyere hastigheter.
Når det er sagt, kan denne ytelsesøkningen bare observeres når instruksjonene som er definert i et program er optimalisert for å kjøre på AVX-512-instruksjonssettet. Ellers vil de være fullstendig ubrukelige, og gitt den begrensede bruken av AVX-512, skjer dette sjelden.
Av denne grunn er instruksjonssettarkitekturer som AVX-512 bedre egnet for server- og HPC- arbeidsbelastninger , men ikke for den gjennomsnittlige forbrukeren. Derfor gir det ikke mye mening å gjøre det på denne måten.
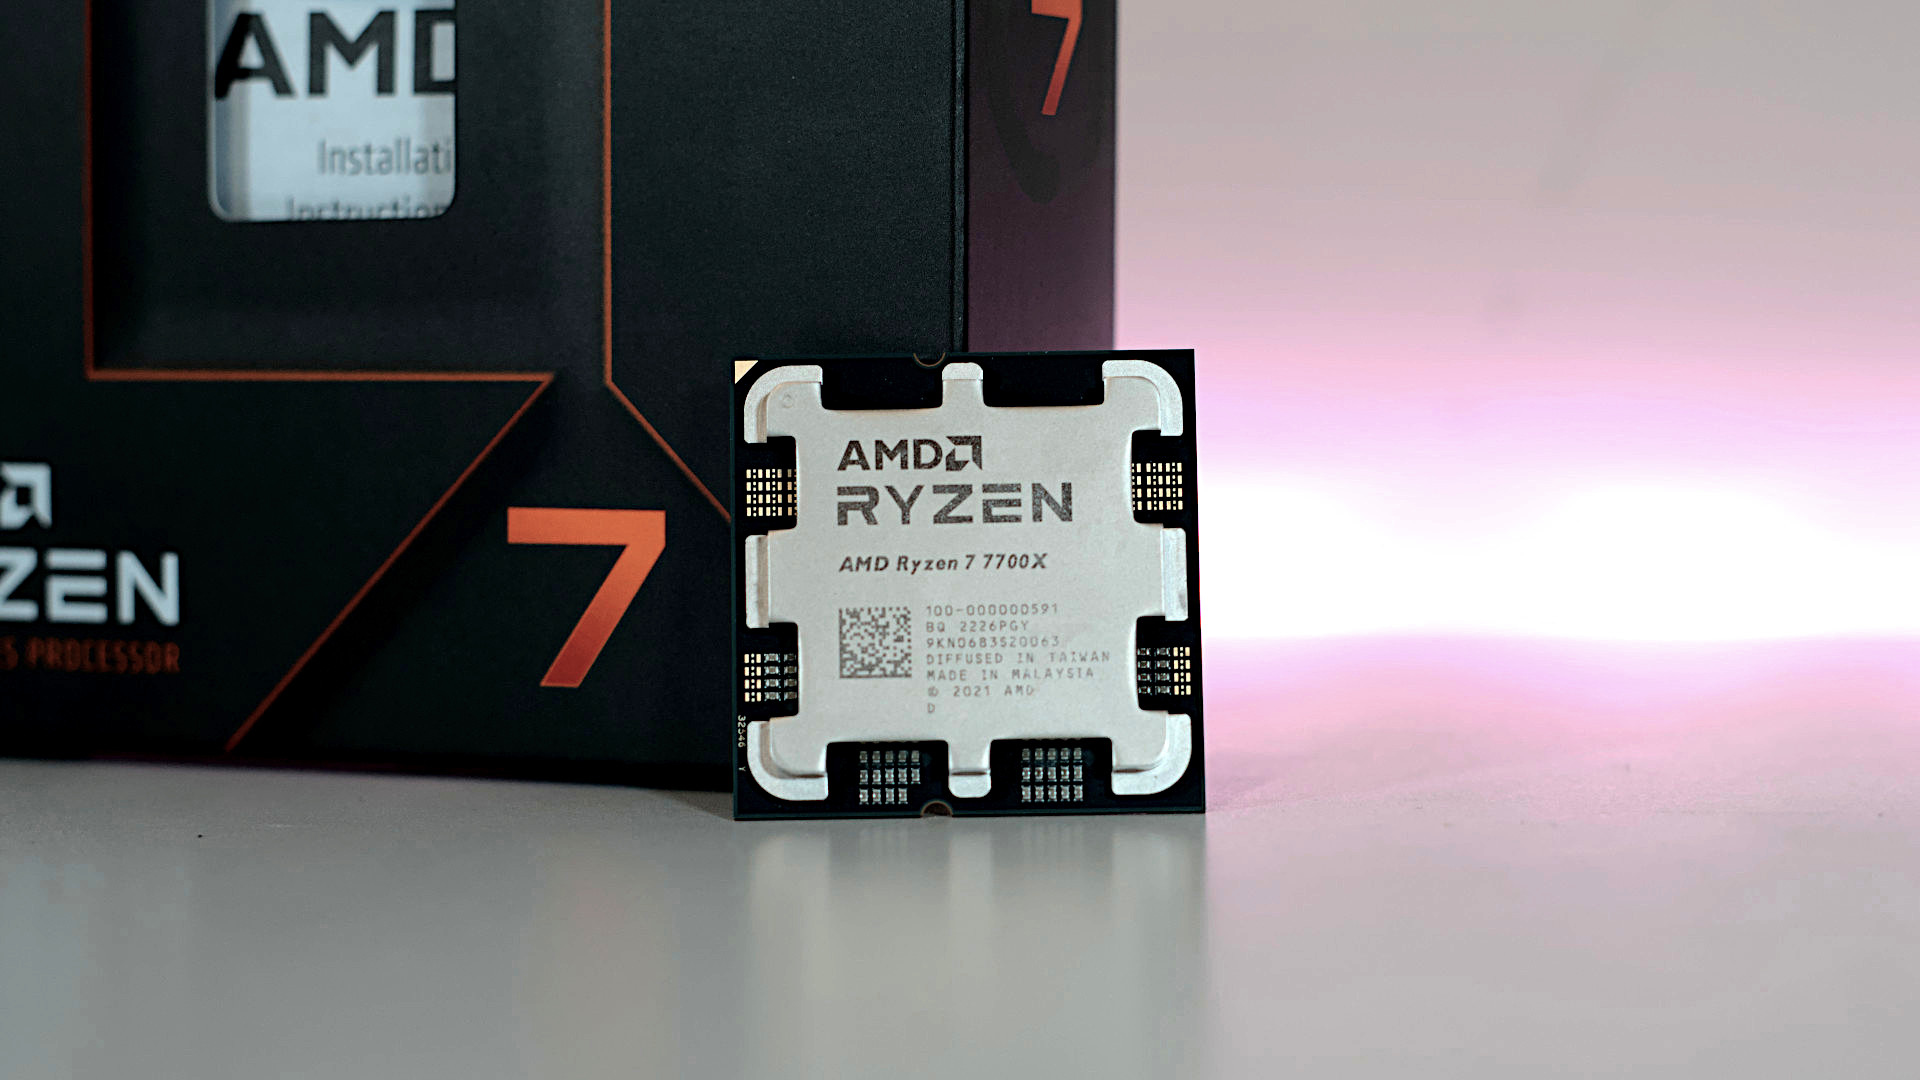
Så hvorfor har AMD integrert dem nå? Den gang gjorde de lurt i å holde seg unna for å unngå de samme problemene som Intel møtte. Men nå har de tatt den motsatte tilnærmingen og tatt dem i bruk også. Dette kan skyldes at mikroarkitekturene designet av AMD, som Zen 4 , brukes for Ryzen-, Threadripper- og EPYC-prosessorer, og kanskje har de laget en enkelt arkitektur for alle brikkene sine, akkurat som Intel gjorde. På denne måten kan AMD nå også jobbe med AVX-512 i servere, arbeidsstasjoner og HPC-systemer for å konkurrere med Xeon-prosessorer.
Hvorfor har Intel fjernet dem fra Alder Lake?
Intels støtte for AVX-512-instruksjoner med Alder Lake-prosessorene har vært en uklar affære . Selskapet hevdet opprinnelig at funksjonen ikke ville fungere på deres nye 12. generasjons prosessorer og senere. Men de snudde senere da hovedkortleverandører fant flere løsninger for å aktivere disse instruksjonene via fastvare.
På denne måten kan dette alternativet aktiveres eller deaktiveres fra hovedkortets BIOS/UEFI, noe som gir brukerne muligheten til å bruke AVX-512 eller ikke, avhengig av arbeidsmengdebehovene deres.
Det ser imidlertid ut til at Intel selger noen ikke-K-enheter – de som ikke er låst opp for overklokking – med AVX-512 deaktivert som standard . Og selv om det ikke ser ut til å være fjernet på maskinvarenivå fra disse produktene, ville denne blokkeringen hindre brukere i å dra nytte av det.
Men det ser ut til at Intel har lekt med musen og musen, siden det endelig ser ut til at det amerikanske selskapet har valgt fysisk deaktivere støtte AVX-512-instruksjoner brukes i forbrukerbrikkene deres på silisiumnivå, så ingenting kan gjøres for å bruke disse instruksjonene, alt i navnet for å øke energieffektiviteten.
Det vil si, i oppsummering, at svingene Intel har gjort har vært:
- Han fortalte pressen at AVX-512 ikke ville være kompatibel med de nye hybridprosessorene.
- Før lanseringen dukket det opp en optimaliseringsguide som viste hvordan man bruker denne funksjonen.
- Intel benektet igjen at disse instruksjonene ble støttet, kanskje på grunn av all kritikken de hadde mottatt tidligere. Deretter fjernet de referansene fra denne veiledningen.
- Da Alder Lake ble utgitt, ble det oppdaget at instruksjonene fungerte på noen hovedkort med riktig firmware. Dette var noe hovedkortprodusentene gjorde mot Intels ønsker.
- Intel forble i utgangspunktet tause, men fortalte taiwansk presse at støtte for AVX-512 var til stede, men ikke som standard, så hvis noen ønsket å bruke det på egen risiko, kunne de det, akkurat som de påtar seg risikoen ved overklokking ...
- I fjor annonserte Intel at de endelig deaktiverte AVX-512 med en ny fastvare- eller mikrokodeoppdatering.
- Samme uke dukket det opp BIOS/UEFI-utgivelser som deaktiverte AVX-512-alternativet.
- MSI fant en måte å omgå denne Intel AVX-512-låsen, noe som muliggjør enkle endringer i BIOS/UEFI.
- Intel var ikke fornøyd med dette og bestemte seg til slutt for å deaktivere instruksjonssettet i maskinvaren, slik at det ikke kunne tukles med på noen måte. Derfor vil det være fysisk tilgjengelig på tidlige Alder Lake-bygg, mens det ikke vil være tilgjengelig på senere Alder Lake-bygg.
Derfor, hvis du vil ha AVX-512 aktivert, må du kjøpe Intel Xeon , som selvfølgelig er dyrere.
Gjennom hele denne sagaen har AMD nå grepet inn og lagt til AVX-512-støtte til alle sine Zen 4-brikker, til og med forbrukermodeller. Så hvis du ønsker en prosessor til PC-en din som støtter AVX-512, er en Ryzen 7000 (Zen 4) det beste alternativet for øyeblikket ...
Hva er VNNI?
Og til slutt vil jeg ikke avslutte uten å nevne AVX-512 VNNI , en utvidelse spesielt utviklet for å akselerere konvolusjonelle nevrale nettverksalgoritmer. VNNI står for Vector Neural Network Instructions.
Disse instruksjonene utvider de opprinnelige AVX-512-utvidelsene, med fire nye instruksjoner for å akselerere nevrale nettverksløkker. Disse instruksjonene er:
VPDPBUSDDenne instruksjonen kan multiplisere de individuelle bytene (8 bit = 1 byte) til den første kildeoperand med de tilsvarende bytene til den andre kildeoperand, noe som gir 16-bits ordresultater som summeres og akkumuleres til en måloperand med to ord (32-bit).VPDPBUSDS: samme som ovenfor, bortsett fra at den mellomliggende sumoverløpet mettes ved 0x7FFF_FFFF/0x8000_0000 for positive/negative tall.VPDPWSSDI denne andre instruksjonen kan de individuelle ordene (16 bits) i den første kildeoperand multipliseres med det tilsvarende ordet i den andre kildeoperand, noe som gir mellomliggende ordresultater som legges til og akkumuleres i et dobbeltord (32 bits) i destinasjonsoperand.VPDPWSSDSSom du kan forestille deg, er den den samme som den forrige, bortsett fra at den mellomliggende sumoverløpet mettes ved 0x7FFF_FFFF/0x8000_0000 for positive/negative tall.
Hovedmotivasjonen bak AVX512 VNNI-utvidelsen er observasjonen av at mange tette konvolusjonelle nevrale nettverksløkker krever gjentatt multiplikasjon av to 16-bits eller to 8-bits verdier og akkumulering av resultatet i en 32-bits akkumulator. Dette er mulig ved hjelp av to instruksjoner, VPMADDWD som brukes til å multiplisere to 16-bits par og legge dem sammen etterfulgt av én VPADDD som legger opp den akkumulerte verdien.