
ご存知のとおり、CPUはソフトウェアを処理してコンピュータシステム全体を動作させます。プログラムは命令とデータで構成され、命令は期待される結果を得るためにデータに対してどのような操作を実行するかを指示します。このようにしてすべての処理が実行されます。CPUの中で最も重要なユニットの1つがALUまたはFPUで、これは数学演算を担当します。そして、Intelプロセッサなどの最新のプロセッサには、最大512ビットのデータ長を持つベクトル命令を実行できる機能ユニットが搭載されており、ここではAVX-512について説明します。
これらの拡張機能は、特に多数の演算を必要とする科学計算などの特定のワークロードの処理を高速化することを目的としています。しかし、AVX-512が登場した当初、インテルは必ずしもこれを歓迎したわけではありませんでした。多くの人がこの機能追加を嫌い、後述するようにいくつかの問題にも遭遇しました。
以下もご興味があるかもしれません:
ALU はどのように機能しますか?
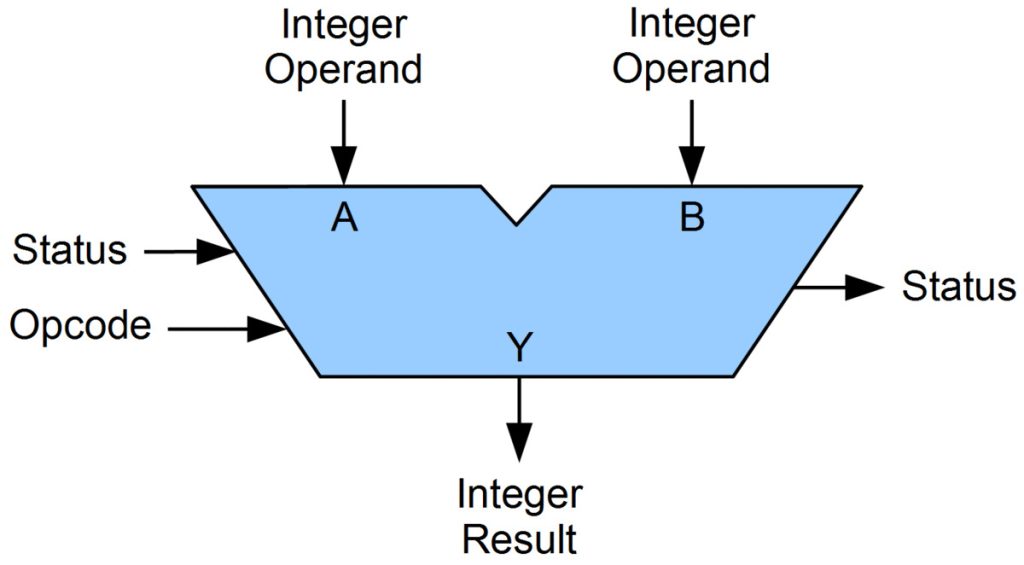
AVX-512命令セットについて詳しく学ぶ前に、まずALU(算術論理演算装置)、つまり算術論理演算ユニットがどのように動作するのかを理解することが重要です。
つまり、このユニットは加算、乗算、除算などの演算を含む計算を実行します。これらのタスクを実行するために、ALUはCPUの制御ユニットによって制御される特定のデジタル回路を使用します。制御ユニットがメモリから処理対象の命令をフェッチしてデコードすると、レジスタにロードされる2つのデータに対して何を行うかをALUに指示するオペコードが送信されます。たとえば、ADD命令は加算、SUB命令は減算、MUL命令は乗算、DIV命令は除算などです。
さらに、このALUは、CPUの他のユニットと同様に、クロック周波数によって決まる速度で動作します。例えば、クロック周波数が5GHzであれば、簡単に言えば、毎秒5.000億回の演算を実行します。
とはいえ、CPUのクロック速度が上がると、CPUが発する熱量も増加します。そのため、単に周波数を上げるだけではパフォーマンス向上にはつながりません。このため、CPU設計者は、コアレベル並列処理、レジスタリネーミング、予測と投機、アウトオブオーダー実行、スーパースカラシステムなど、代替的なパフォーマンス向上策を模索する必要があります。演算能力を高めるための対策の一つとして、より大きなデータセットを処理できるSIMD命令(ベクトル命令)の利用が挙げられます。
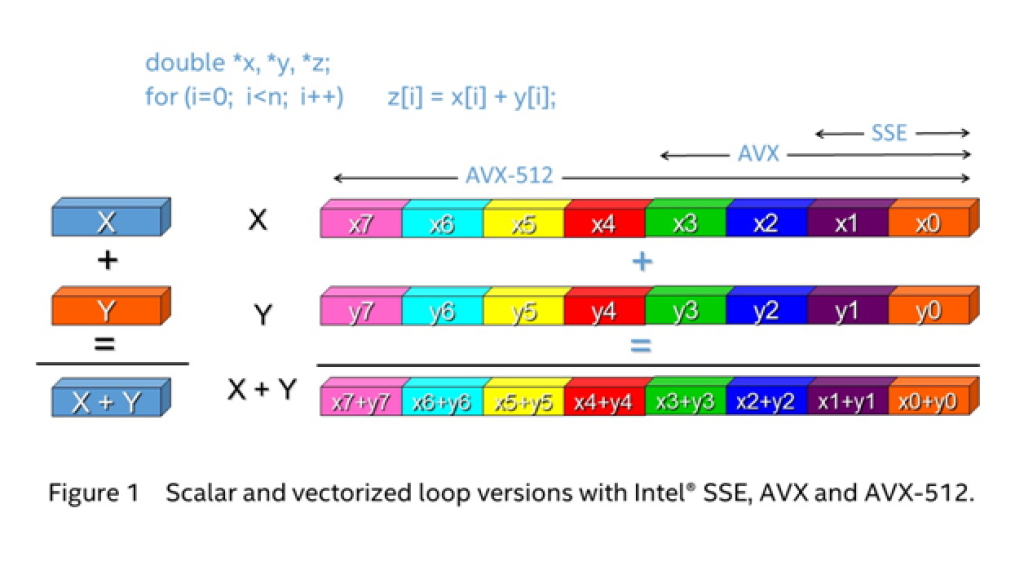
これらの命令の一例として、AVX-512が挙げられます。他のユニットは64ビットデータで動作しますが、これらの拡張機能用の特殊ユニットは512ビットデータで動作するため、通常のワードサイズの8倍のデータを一度に処理できます。そのためには、より大きく複雑なALU(整数演算用)またはFPU(浮動小数点演算用)が必要となり、結果としてチップサイズが大きくなり、コストが増加するなど、様々な問題が生じます。
データはどのようにして ALU に届くのでしょうか?
これで、ALUとは何か、どのように動作するのか、そしてAVX-512が基本的なレベルで何に使われるのかについて基本的な理解が得られたので、次のステップはデータがどのようにALUに到達するのかを学ぶことです。これは、これらの拡張機能を理解するのにも役立ちます。
ALUに到達するには、データはさまざまなストレージシステムを経由する必要があります。このデータ経路は、コンピュータシステムのメモリ階層に基づいています。この階層構造を簡単に説明すると次のようになります。
- 二次メモリ: これらは大容量記憶媒体、つまり HDD や SSD ハードドライブ、そして光学メディアなど、I/O システムに接続される可能性のあるその他のドライブです。これらのドライブには大量の情報が保存されますが、CPU の速度に比べてメモリ速度が遅いため、これらのメディアにアクセスすると遅延が大きくなり、ペナルティが発生します。そのため、このペナルティを回避するには、このデータをプライマリメモリにロードする必要があります。これについては次の項目で説明します。例えば、より分かりやすくするために、ハードドライブに Word がインストールされていて、それを実行したいとします。このソフトウェアは、CPU が実行するために必要な命令とデータを含む一連の実行可能ファイルまたはバイナリで構成されています。また、USB フラッシュドライブや DVD からオペレーティングシステムをインストールした場合など、実行したいソフトウェアがハードドライブ上に存在しない場合もあります。その場合、命令とデータを含む実行可能バイナリもそこにあります。
- 主記憶: プライマリストレージシステムは、ランダムアクセスメモリ(RAM)で構成されています。このストレージシステムはセカンダリストレージシステムよりも高速ですが、電源投入時に情報を保存する揮発性メモリであるため、保存できる情報量は少なく、永続的に保存することもできません。つまり、コンピューターの電源を切っても、インストールしたプログラムは消去されませんが、RAMの内容は消去されます。前述のように、プロセスまたはプログラムがRAMにロードされる際に実際に行われているのは、実行可能バイナリの命令とデータをセカンダリユニットからプライマリユニットに転送することです。プライマリユニットはCPUがより高速にアクセスできるデバイスです。
- キャッシュ: キャッシュはCPUに組み込まれており、最も高速なメモリシステムですが、容量が非常に小さく、揮発性です。このメモリシステムは一般的にL1、L2、L3のXNUMXつの部分に分かれています。ALUで処理する必要があるデータは、ハードドライブからRAMへ、そしてキャッシュへ移動されます。しかし、ALUはキャッシュのデータに直接アクセスすることはできません。そのため、ALUはさらに小型で高速な別のメモリを必要とします。これが次のポイントです…
- CPUレジスタ: CPUレジスタは、非常に高速なフリップフロップ要素で構成された非常にシンプルなメモリです。CPUアーキテクチャに応じて、レジスタのサイズは変更できます。たとえば、8ビット、16ビット、32ビット、64ビットなどです。さらに、レジスタの数は可変であり、それらすべてがCPUのレジスタウィンドウまたはファイルを構成します。ALUやFPUなどのコンピューティングユニットは、これらのレジスタにロードされたデータにアクセスできます。したがって、フェッチサイクルで命令がRAMからCPUにフェッチされると、命令は制御ユニットによってデコードまたは解釈され、その命令の実行に伴う内容が決定されます。たとえば、ADD r1、r2、r3は、レジスタr2 + r3のデータを加算し、結果をr1に格納します。このように、制御ユニットはこのオペコードをALUに送信し、値とデータ(この場合は必要なレジスタ)の位置を加算するように指示します。次にALUがデータにアクセスし、加算演算を実行します。これがこの階層の仕組みです。
さらに、ご存じのとおり、最も頻繁に使用されるデータと命令はキャッシュに保存され、将来再び必要になった場合に高速にアクセスできます。ご想像のとおり、キャッシュレベルが上がるごとに高速化されます。
- L1これは最初のレベルで、最も高速で、レイテンシが最も低いです。つまり、アクセス時に無駄になるクロックサイクルが少ないということです。さらに、このメモリは通常、データ用のL1DまたはL1と、命令用のL1IまたはL1に分割されています。つまり、命令とデータが混在することはありません。
- L2これは次のレベルのキャッシュで、L1よりも容量が大きいですが、やや遅いため、アクセスに多くのサイクルが必要です。ここでは、データと命令が統合されているため、混在して使用されます。
- L3このレベルはL2よりも容量が大きいですが、L2よりもさらに低速です。また、L2と同様に統合型で、データと命令の両方を保存します。L3が最後のレベルである場合、LLC(Last Level Cache)とも呼ばれますが、他のシステムではL4など、他のレベルが使用される場合もあります。
ご想像のとおり、CPUがデータや命令を検索する必要がある場合、パフォーマンスを向上させるために、まずL1を検索します。これは、アクセスに必要なクロックサイクルが最も少ないためです。L2に見つからない場合は、次に高速なL3を検索します。L3にも見つからない場合は、LXNUMXを検索します。LXNUMXにも見つからない場合は、RAMを検索する、というように続きます。
AVX-512 とは何ですか? どのように機能しますか?
AVX-512命令セットはAVXの第2世代であり、2013年にインテル製プロセッサに搭載されました。AVXはAdvanced Vector Extensionsの略で、インテルのXeon Phi(Knights Landing)プロセッサで初めて導入され、その後Skylake-XベースのXeonプロセッサでインテルのサーバープロセッサにも搭載されました。
さらに、AVX-512命令セットは、Cannon Lakeアーキテクチャを搭載した一般消費者向けコンピュータ(PC)にも搭載され、後にIce LakeおよびTiger Lakeアーキテクチャとも互換性を持つようになりました。これはおそらく最も批判された措置の一つであり、決して取るべきではなかった措置でした。その理由の一つは、これらの命令を活用できるソフトウェアが十分に存在しなかったこと、もう一つは、これらのシステムに複雑さを増すものだったからです。
前述のとおり、ALU/FPUはCPUのレジスタに格納されているデータにしかアクセスできません。AVX命令セットはこれらのレジスタのサイズを拡大します。このサイズ拡大により、1つの命令で複数のデータ項目を処理できるようになり、パフォーマンスが向上します。
この命令セットの主な目的は、データ圧縮、画像処理、暗号計算に関連するタスクを高速化することでした。AVX-256と比較して2倍の演算能力を提供するAVX-512命令セットは、大幅なパフォーマンス向上を実現しました。しかし、多くの人が想像するように、これらのIntel製CPUのパフォーマンスを2倍にしたわけではありません。
Intel が AVX-512 を廃止する理由は何ですか?
前述の通り、AVX-512命令セットは計算処理においていくつかの利点をもたらしますが、そのすべてが歓迎されたわけではありません。TensorFlowのような人気ライブラリが、この命令セットをサポートするCPU上でより高速な計算を実現するためにこの命令セットを使用しているのは事実です。
AMDはZen 512ベースのマイクロプロセッサで初めてAVX-4を採用しました。両社間の完全な移行は…
では、なぜインテルは最新のAlder LakeプロセッサでAVX-512を無効化しているのでしょうか? 実は、完全に削除されたわけではありません。例えば、Alder Lakeプロセッサは、高性能なPコアと高効率なEコアを備えた、異種マルチコアアーキテクチャを採用しています。
PコアはGolden Coveマイクロアーキテクチャに基づいており、これらの命令を実行できますが、Gracemontマイクロアーキテクチャに基づくEコアは実行できません。これらのコアのスケジューラは、コアのサイズを小さく保ち、エネルギー効率を高めるために、このような命令を拒否します。
一方、Alder Lake以降のCPUはAVX-512命令セットに対応していません。これは、AVX-512命令セットに対応していないと、Eコア上で特定のプログラムを実行できなくなるためです。ただし、HPCやサーバー向けのXeonプロセッサなど、Intelがこれらのコアを物理的に統合していない他のCPU、さらにはBIOS/UEFIでEコアを無効化できるシステムでは使用できます。
コンシューマー向け CPU には AVX-512 が必要ですか?
AVX-512命令セットは、CPUのレジスタサイズを拡大することでパフォーマンスを向上させます。このパフォーマンス向上により、 CPUはより高速に数値を処理できるようになり、ユーザーはビデオ/オーディオ圧縮アルゴリズムをより高速に実行できるようになります。
とはいえ、このパフォーマンス向上は、プログラムで定義された命令がAVX-512命令セットで実行するように最適化されている場合にのみ実現可能です。そうでなければ、それらの命令は全く役に立たず、AVX-512の普及が限られていることを考えると、そのようなケースは稀です。
このため、AVX-512のような命令セットアーキテクチャは、サーバーやHPCのワークロードには適していますが、一般消費者向けではありません。したがって、このようなやり方はあまり意味がありません。
では、なぜAMDは今になってAVX-512を統合したのでしょうか?当時、AMDはIntelが直面したのと同じ問題を避けるために、AVX-512には手を出さないという賢明な判断を下していました。しかし、今やAMDは正反対のアプローチを取り、AVX-512を採用しています。これは、AMDが設計したZen 4などのマイクロアーキテクチャがRyzen、Threadripper、EPYCプロセッサに使用されており、Intelと同様に、すべてのチップに共通のアーキテクチャを作成したためかもしれません。こうすることで、AMDはサーバー、ワークステーション、HPCシステムでもAVX-512に対応し、Xeonプロセッサと競合できるようになったのです。
Intel が Alder Lake からそれらを削除したのはなぜですか?
IntelがAlder LakeプロセッサでAVX-512命令をサポートするかどうかは、曖昧なままだった。同社は当初、この機能は新しい第12世代以降のプロセッサでは動作しないと主張していた。しかし、マザーボードメーカーがファームウェアを介してこれらの命令を有効にするいくつかの回避策を発見したことで、後に方針を転換した。
このように、このオプションはマザーボードのBIOS/UEFIから有効または無効にすることができ、ユーザーはワークロードのニーズに応じてAVX-512を使用するかどうかを選択できます。
しかし、Intelはオーバークロックに対応していない非Kモデルの一部で、AVX-512をデフォルトで無効にした状態で販売しているようだ。これらの製品ではハードウェアレベルでAVX-512が削除されているわけではないようだが、この無効化によってユーザーはその機能を利用できなくなる。
しかし、インテルはマウスとマウスで遊んでいるようで、最終的にアメリカの会社は サポートを物理的に無効にする AVX-512 命令はシリコン レベルでコンシューマー チップに使用されているため、エネルギー効率の向上という名目でこれらの命令を使用することはできません。
つまり、まとめると、Intel が行った変化は次のようになります。
- 同氏は報道陣に対し、AVX-512は新しいハイブリッドプロセッサと互換性がないと語った。
- リリース前に、この機能の使用方法を示す最適化ガイドが公開されました。
- Intelは、おそらく過去に受けた批判のせいか、これらの命令がサポートされていることを再度否定し、その後、このガイドから参照を削除しました。
- Alder Lakeがリリースされた際、適切なファームウェアを搭載した一部のマザーボードで命令が動作することが発覚しました。これは、マザーボードメーカーがIntelの意に反して行った行為でした。
- インテルは当初沈黙していたが、台湾の報道機関に対しては、AVX-512 のサポートは存在するがデフォルトではないため、オーバークロックのリスクを負うのと同じように、自己責任で使用したい場合は使用できると伝えた…
- 昨年、Intel は新しいファームウェアまたはマイクロコードのアップデートで AVX-512 を最終的に無効にすることを発表しました。
- 同じ週に、AVX-512 オプションを無効にした BIOS/UEFI リリースが登場しました。
- MSI は、この Intel AVX-512 ロックをバイパスする方法を見つけ、BIOS/UEFI を簡単に変更できるようにしました。
- Intelはこれに不満を抱き、最終的にハードウェアで命令セットを無効化することを決定しました。これにより、いかなる改ざんも不可能になりました。そのため、初期のAlder Lakeビルドでは物理的に利用可能になりますが、後期のAlder Lakeビルドでは利用できなくなります。
したがって、AVX-512を有効にしたい場合は、当然ながらより高価なIntel Xeonを購入する必要があります。
この一連の騒動の中で、AMDはついに介入し、コンシューマー向けモデルも含め、すべてのZen 4チップにAVX-512のサポートを追加しました。したがって、AVX-512をサポートするプロセッサをPCに搭載したいのであれば、現時点ではRyzen 7000(Zen 4)が最良の選択肢と言えるでしょう。
VNNIとは何ですか?
最後に、畳み込みニューラルネットワークアルゴリズムを高速化するために特別に設計された拡張機能であるAVX-512 VNNIについて触れずに終わりたくはありません。VNNIはVector Neural Network Instructionsの略です。
これらの命令は、初期のAVX-512拡張機能を拡張したもので、ニューラルネットワークのループ処理を高速化するための4つの新しい命令が含まれています。これらの命令は以下のとおりです。
VPDPBUSDこの命令は、最初のソース オペランドの個々のバイト (8 ビット = 1 バイト) を 16 番目のソース オペランドの対応するバイトで乗算し、32 ビット ワードの結果を生成し、それらを合計してダブル ワード (XNUMX ビット) の宛先オペランドに累積します。VPDPBUSDS: 中間合計オーバーフローが正/負の数に対して 0x7FFF_FFFF/0x8000_0000 で飽和することを除いて上記と同じです。VPDPWSSD: この他の命令では、最初のソース オペランドの個々のワード (16 ビット) を 32 番目のソース オペランドの対応するワードで乗算し、中間ワードの結果を生成します。この結果は、宛先オペランドのダブル ワード (XNUMX ビット) に加算され、累積されます。VPDPWSSDS: ご想像のとおり、中間合計オーバーフローが正/負の数に対して 0x7FFF_FFFF/0x8000_0000 で飽和する点を除けば、前のものと同じです。
AVX512 VNNI拡張の主な目的は、多くのタイトな畳み込みニューラルネットワークループにおいて、16つの8ビット値または32つのXNUMXビット値の乗算を繰り返し、その結果をXNUMXビットのアキュムレータに蓄積する必要があるという観察に基づくものです。これは、以下のXNUMXつの命令で実現できます。 VPMADDWD 16つのXNUMXビットペアを乗算し、それらを加算してXNUMXつ追加するために使用される VPADDD 累積値を加算します。