- La evolución de la IA generativa permite suplantar identidades vocales con muestras de audio extremadamente breves, vulnerando la biometría tradicional.
- La defensa efectiva requiere un enfoque multicapa que combine análisis estadísticos, marcas de agua digitales y procesos de verificación independientes.
- El impacto de estas falsificaciones trasciende lo económico, afectando la salud psicológica de las víctimas y la confianza general en los medios digitales.
Imagínate despertar un día y descubrir que alguien puede hablar exactamente como tú, con tu mismo tono y cadencia, sin haberte pedido permiso. Lo que hace unos años parecía una fantasía de películas como Misión Imposible, hoy es una realidad tangible gracias a la inteligencia artificial generativa. Ya no hace falta pasar horas grabando en un estudio; basta con unos pocos segundos de una entrevista en YouTube o un audio de WhatsApp para que un software cree una copia digital casi perfecta de nuestra identidad sonora.
Este fenómeno ha abierto una caja de Pandora donde la línea entre lo auténtico y lo sintético es cada vez más borrosa. No se trata solo de bromas pesadas o parodias, sino de una herramienta que está siendo utilizada para estafas financieras sofisticadas y manipulaciones políticas a gran escala. En un mundo donde confiar en lo que oímos era la norma, ahora nos enfrentamos al reto de reconstruir la seguridad digital basándonos en la desconfianza razonable y en herramientas tecnológicas de vanguardia.
La vulnerabilidad de la voz como firma personal
Durante mucho tiempo, hemos considerado nuestra voz como un rasgo biométrico estable y único. Sin embargo, la clonación moderna ha convertido este rasgo en un material reutilizable y copiable. Mediante técnicas de síntesis de texto a voz (TTS) y conversión de voz (VC), los atacantes pueden imitar patrones articulatorios y timbres específicos. Modelos avanzados, como los desarrollados por grandes tecnológicas, pueden lograr una imitación asombrosa con solo tres segundos de audio, permitiendo que el impostor diga cualquier frase con la identidad de la víctima.
El problema es que nuestra capacidad humana para distinguir estas falsificaciones es, siendo generosos, mediocre. Diversos estudios indican que la precisión de las personas para detectar un deepfake es similar al azar, especialmente cuando el audio es procesado para eliminar ruidos o se presenta en contextos emocionales convincentes. Esto convierte al teléfono en un blanco fácil, ya que la familiaridad de una voz reduce nuestras defensas y nos empuja a tomar decisiones rápidas sin verificar la fuente.
Impacto real: Del fraude financiero al daño psicológico
Los casos de suplantación ya no son anécdotas aisladas. Hemos visto desde directores de empresas que transfieren millones de dólares creyendo hablar con sus superiores, hasta abuelos engañados por supuestos nietos en apuros. Estos ataques suelen ir acompañados de ingeniería social, donde el estafador crea una narrativa urgente para anular el pensamiento crítico de la víctima. Pero el daño no es solo monetario; existe un componente psicológico profundo al sentir que se ha perdido el control sobre la propia identidad.
Además, el uso de deepfakes en el ámbito sentimental, como las estafas románticas potenciadas por videollamadas con rostros y voces alteradas, demuestra que la IA puede manipular la confianza más íntima. Esta pérdida de seguridad genera un efecto dominó donde, tras descubrir el engaño, las personas tienden a desconfiar de todo el contenido, incluso del auténtico, erosionando la credibilidad de la comunicación digital en general.
Tecnologías de detección y countermeasures
Para combatir esta plaga, se están desarrollando sistemas de detección que no dependen del oído humano. La detección convencional se basa en el aprendizaje profundo y análisis estadísticos para encontrar anomalías que el cerebro ignora, como inconsistencias en la frecuencia, ruidos artificiales introducidos por el generador o falta de coherencia en la prosodia. Algunos modelos transforman el audio en espectrogramas (imágenes del sonido) y utilizan redes neuronales convolucionales para clasificar si la señal es real o sintética.
- Análisis Multimodal: La forma más robusta de detección es cruzar datos. Si hay un vídeo, se analiza la sincronía labial y la coherencia entre el movimiento del rostro y la onda sonora.
- Marcas de Agua Digitales: Algunos proveedores insertan información invisible en la frecuencia del audio. Si el audio original tiene marca, es fácil de rastrear; si no la tiene pero suena a la marca de una IA específica, se puede confirmar la síntesis.
- Detección de Re-grabación: Existen algoritmos capaces de distinguir si una voz sale directamente de una garganta humana o si está siendo reproducida a través de un altavoz durante una llamada.
Hacia una estrategia de seguridad en capas
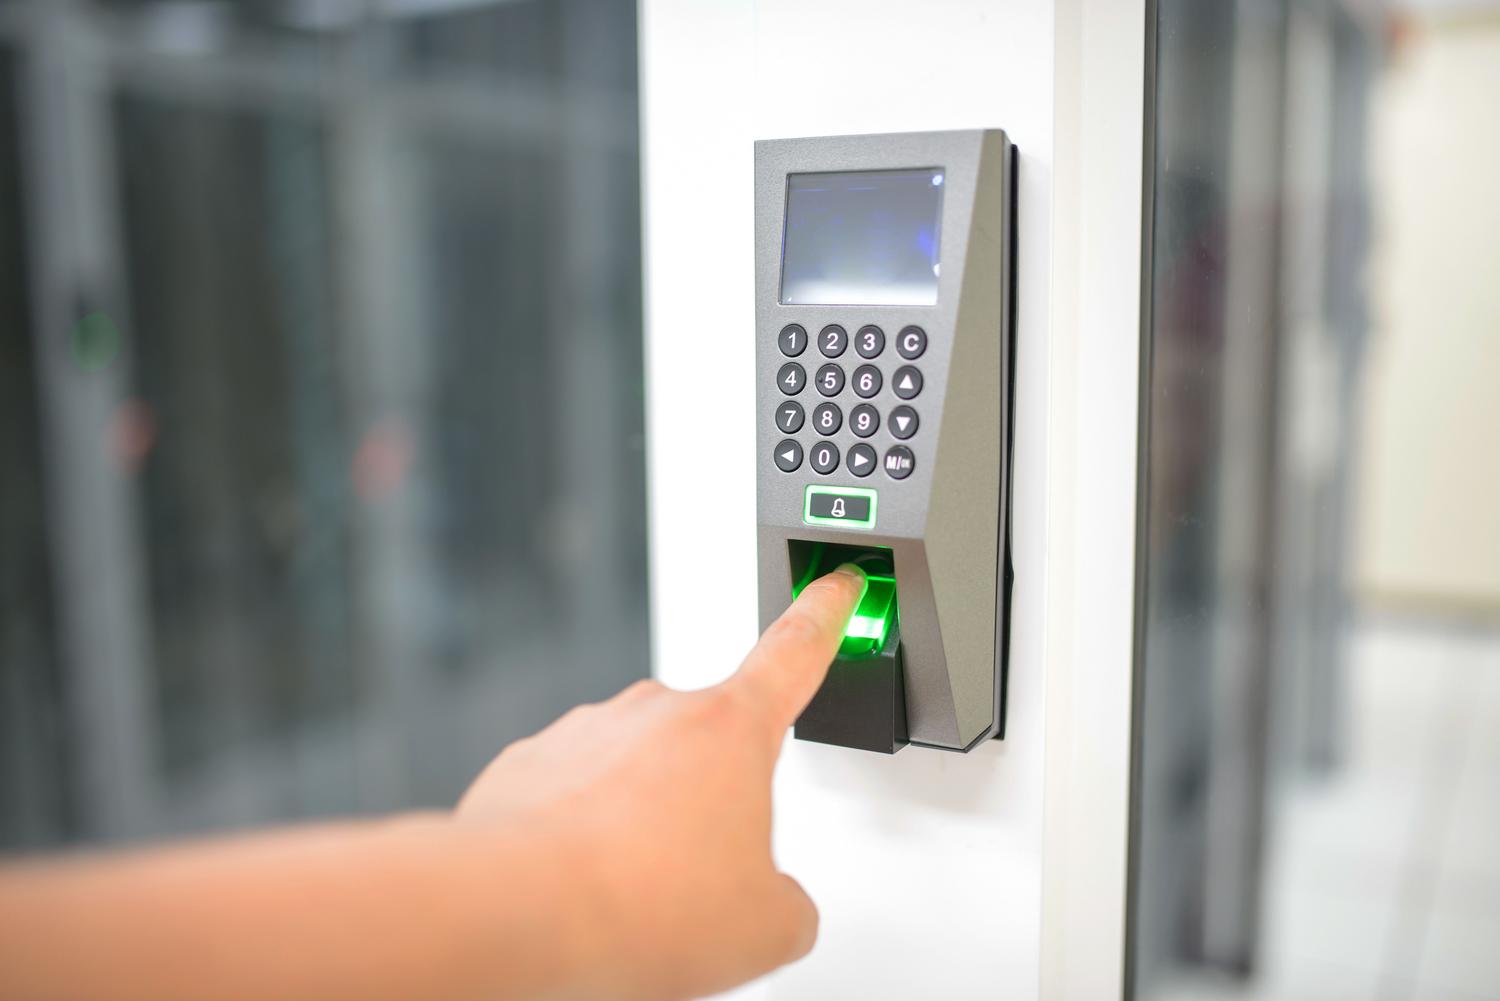
Dado que ningún detector es perfecto y que los atacantes siempre encuentran nuevas formas de evadir los filtros, la solución no es una herramienta única, sino una arquitectura de defensa multicapa. No podemos permitir que la voz o el rostro sean la única credencial para operaciones sensibles. Es fundamental separar la identificación (quién parece ser) de la autenticación (cómo prueba que es él).
Una estrategia inteligente implica implementar la autenticación multifactor, donde la voz sea solo un complemento. Si recibimos una llamada sospechosa, lo más sensato es aplicar un protocolo de verificación independiente: hacer una pregunta sobre un dato que solo la persona real conozca o contactar por un canal distinto. En el ámbito empresarial, esto se traduce en el uso de firmas digitales y el registro de consentimiento verificable mediante tecnologías como el blockchain para asegurar que la voz no ha sido manipulada.
Desafíos legales y el futuro de la identidad
El derecho está corriendo detrás de la tecnología. Actualmente existe una tensión jurídica sobre si la voz debe tratarse como una propiedad privada, un dato personal o un activo explotable. La falta de estándares globales y regulaciones claras permite que muchas aplicaciones de clonación operen en una zona gris, delegando toda la responsabilidad al usuario final mientras recopilan datos biométricos masivos.
El futuro nos obligará a aceptar que ver u oír ya no es prueba suficiente de presencia o voluntad. La investigación actual se centra en crear modelos más ligeros que puedan funcionar en tiempo real en nuestros móviles y en desarrollar marcos éticos que protejan la identidad sonora. La educación es la herramienta más potente: entender que la IA puede imitar el timbre pero no la memoria ni la esencia de una persona es la mejor defensa contra el engaño.
La lucha contra los deepfakes de audio es una carrera armamentista tecnológica donde la detección debe evolucionar tan rápido como la síntesis. Para no caer en la trampa, es vital combinar la potencia de los analizadores de espectrogramas y las marcas de agua con una dosis saludable de escepticismo y la implementación de procesos de verificación humana y digital que no dependan de una sola señal biométrica.