- NVFP4 combina E2M1 amb escalat dual (FP8 per microblocs i FP32 per tensor) per reduir un 88% l'error de quantització.
- A Blackwell, FP4 aconsegueix fins a 20 PFLOPS per GPU i 3× més rendiment que FP8 en casos reals, amb caigudes mínimes de precisió.
- La memòria s'enfonsa (fins a 8×), l'energia per token cau fins a 50× i els costos d'inferència baixen prop del 90%.
- L'ecosistema ja suporta FP4 (TensorRT, vLLM, HF) i la infraestructura avança amb NVLink 5, refrigeració líquida i racks de 120 kW.
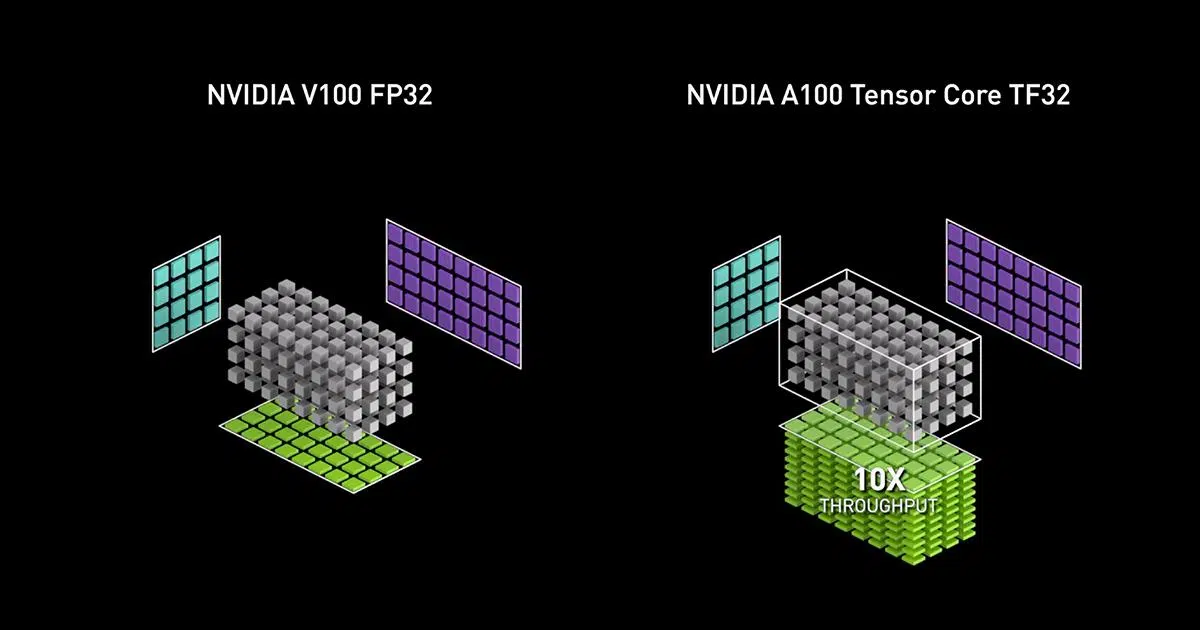
La conversa al voltant dels formats de precisió a IA s'ha accelerat amb l'arribada de NVFP4, i no n'hi ha per menys: reduir bits sense perdre qualitat canvia radicalment l'economia de la inferència. En aquesta guia trobaràs què és NVFP4, en què es diferencia de FP8 i BF16, i per què els grans (i no tan grans) ja ho estan adoptant, des de data centers a PCs de sobretaula.
Més enllà del bombo del màrqueting, hi ha dades sòlides: energia per token retallada fins a 50 vegades , cabals de tokens per segon que baten rècords, i memòria que es desploma a una fracció sense aniquilar la precisió. Tot i així, convé separar titulars de realitat pràctica, perquè l'impacte depèn del maquinari, de l'escalat numèric i de com es quantitza i optimitza cada model.
Què és NVFP4 i en què millora a FP8 i BF16
NVFP4 és la proposta de NVIDIA per a una precisió ultrabaixa pensada per a la inferència de IA. Representa números amb E2M1 (1 bit de signe, 2 d'exponent i 1 de mantisa) i afegeix un ingredient clau: escalat en dos nivells que redueix dràsticament l'error de quantització davant d'aproximacions més simples.
Aquest esquema a dos nivells combina un factor d' escala FP8 E4M3 aplicat a microblocs de 16 valors amb un escalat global per tensor a FP32. Gràcies a aquesta combinació, s'aconsegueix un 88% menys d'error que solucions de potència de dues de més bàsiques com MXFP4, reforçant l'estabilitat numèrica amb tan pocs bits.
En contrast, FP8 (E4M3 o E5M2) ja retalla força cost davant FP16/BF16, però NVFP4 va un pas més enllà disminuint encara més memòria i energia. BF16 manté un rang dinàmic semblant a FP32 amb menys bits a la mantisa, ideal per a entrenament i entorns on l'estabilitat de gradients mana, però per a la inferència massiva el 4-bit ben escalat està marcant diferències.
La conseqüència pràctica: en càrregues de treball ben adaptades, NVFP4 manté una precisió molt propera a formats superiors, però amb salts de velocitat i eficiència memorables. Tot depèn de quantització, calibratge i del suport nadiu del maquinari.
Arquitectura Blackwell: el múscul darrere de NVFP4
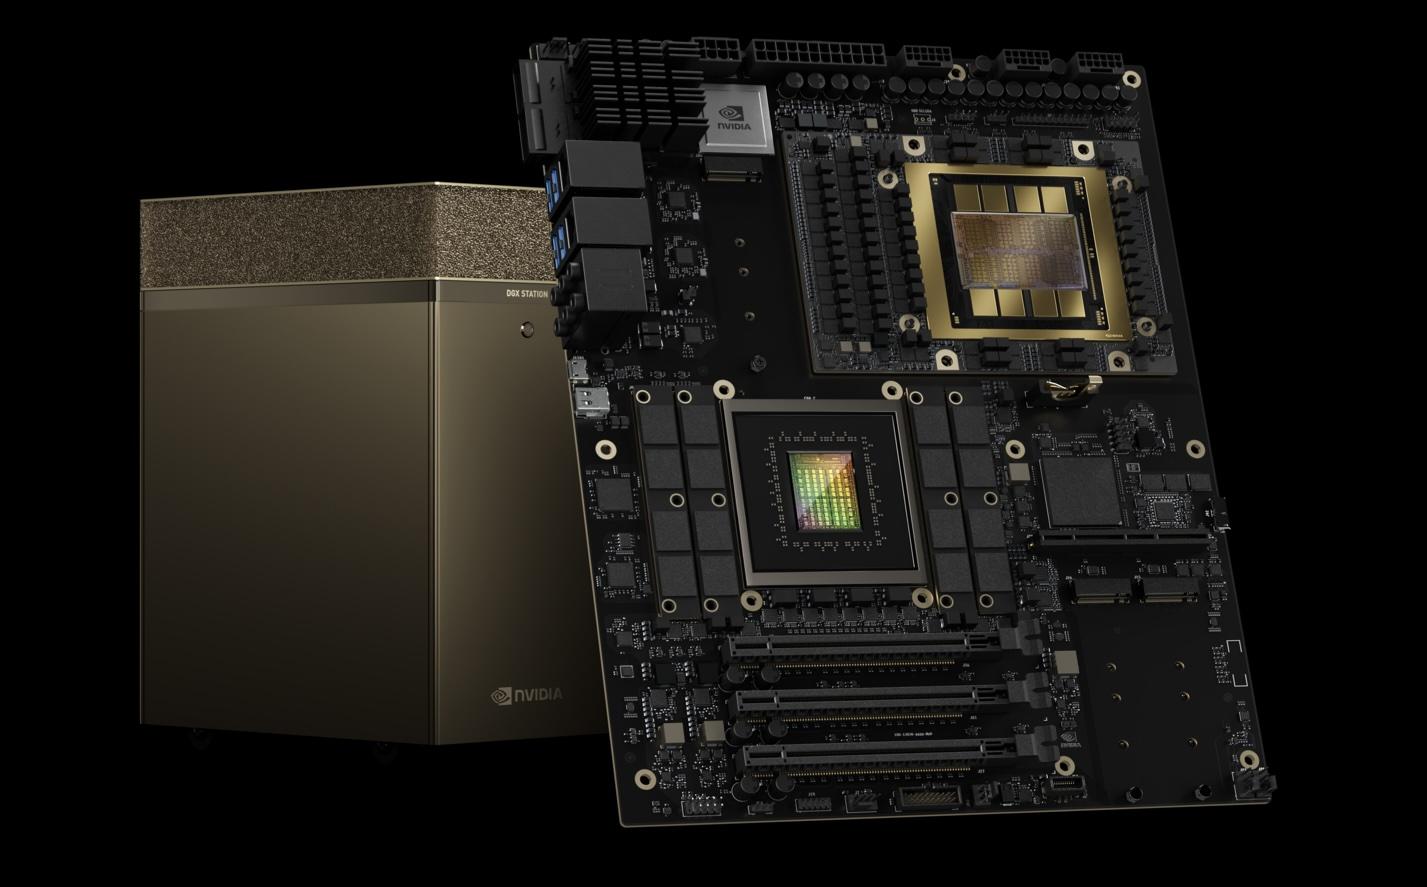
L'arribada de Blackwell ha estat el catalitzador perquè NVFP4 s'enlairi. La GPU B200 integra 208.000 milions de transistors en un disseny de doble xip, units a través d'una interfície NV-HBI de 10 TB/s que es presenta transparent al programari i garanteix un comportament unificat.
Els Tensor Cores de cinquena generació suporten NVFP4 de forma nativa amb escalat accelerat per maquinari, aconseguint fins a 20 PetaFLOPS en FP4 . L'arquitectura incorpora a més memòria tensorial propera a les unitats de còmput (TMEM), limitant el cost energètic del moviment de dades i elevant el rendiment sostingut.
Per a consum, la sèrie GeForce RTX 50 hereta funcions FP4 amb xifres de fins a 4.000 TOPS d'IA i accelera la generació d'imatges (per exemple, FLUX) fins a 3,9 vegades davant d'FP8 en escenaris específics, demostrant que la inferència a 4 bits no és només cosa de centres de dades.
A l'extrem de major escala, Blackwell Ultra (B300/GB300) eleva el llistó amb 288 GB de HBM3E i 1,5× més rendiment que B200, arribant en configuracions NVL72 a fregar 1,1 exaFLOPS per sistema en FP4 dens. Això estableix la base per servir models de centenars de milers de milions de paràmetres amb menys màquines.
Mètriques: més tokens, menys watts i memòria sota control
Les dades de producció i benchmarks pinten un quadre consistent. A DeepSeek-R1 671B, el salt a FP4 a B200 triplica el rendiment respecte a FP8 a H200, amb sistemes DGX B200 que superen els 30.000 tokens/s . La precisió a penes se'n ressent: MMLU baixa del 90,8% al 90,7% en quantitzar de FP8 a FP4.
En memòria, els números són demolidors. Un LLM com Flama 3.1 405B passa de 140 GB en FP32 a 17,5 GB en FP4 , una reducció de 8× que permet servir models massius en menys GPU. En generació d'imatges, una configuració FLUX pot caure de 51,4 GB a FP16 a 9,9 GB a FP4 amb mínima minva visual i adaptant-se a VRAM modesta.
MLPerf v5.0 recolza el moviment: el throughput mitjà de Truca 2 70B es va doblar respecte a l'any anterior i els millors resultats van millorar 3,3×. En energia, el token
de H100 a 10 J baixa a 0,4 J a B200 ia 0,2 J a B300, és a dir, fins a 50× més eficiència. Traduït a negoci, hi ha caigudes properes al 90% en costos d'inferència al llarg de 2024-2025.
A l'extrem d'usuari, els models d'imatge i text amb NVFP4 aprofiten més tokens per dòlar , amb informes de fins a un 40% de millora respecte a alternatives, cosa que combina bé amb la petjada de memòria més petita i la facilitat de servir models de grans dimensions.
Adopció: clouds, empreses i casos reals
Els proveïdors de núvols lideren l'adopció de FP4. Lambda Labs ofereix clusters HGX B200 amb FP4 en desplegaments 1-Click, i CoreWeave registra 800 tokens/sa Llama 3.1 405B amb GPU GB200. No tot és NVIDIA: Meta, OpenAI i Microsoft usen AMD Instinct MI300X en inferència i MI350 arribarà amb suport FP4 nadiu.
A la banca, JPMorgan avalua FP4 per a risc i anàlisi alternatives; en sanitat s'han vist +30% de velocitat amb -50% de memòria , i en manufactura s'habiliten decisions en temps real en dispositius amb recursos limitats, obrint portes on abans no hi havia marge.
El programari acompanya el pas. TensorRT Model Optimizer aporta fluxos de quantització FP4 complets; marcs com vLLM integren suport primerenc per a NVFP4; i Hugging Face acull checkpoints FP4 prequantitzats (DeepSeek-R1, Flama 3.1, FLUX) per accelerar posades en producció.
Per a equips amb menys còmput, hi ha vies sense QAT usant SVDQuant amb precisió propera a entrenament quantitzat; si es busca exactitud màxima, el QAT a FP4 conserva o fins i tot millora davant de BF16 en famílies com Nemotron 4, sempre que s'afini bé el procés.
Infraestructura: potència, refrigeració i noves normes del CPD
La precisió ultrabaixa exigeix redibuixar el centre de dades. Un sistema GB200 NVL72 consumeix 120 kW per rack per a 72 GPU, per sobre de la capacitat de la majoria de CPD existents. Tot i així, un NVL72 substitueix nou HGX H100 i requereix un 83% menys d'energia per al mateix càlcul efectiu.
Amb TDP de ~1.000 W per GPU, la refrigeració líquida directa al xip no és opcional. Plaques fredes a tots els punts calents permeten fer servir refrigerant a 45 ºC i torres de refrigeració, evitant xillers costosos. Solucions com Supermicro DLC-2 arriben a 96 B200 per rack i fins a 250 kW de capacitat tèrmica.
En programari de base, calen controladors CUDA actualitzats , TensorRT-LLM amb suport FP4 i eines especialitzades de quantització. La postquantització amb Model Optimizer accelera la sortida a producció, mentre que l' entrenament amb quantització maximitza la retenció de qualitat.
Mirant a mitjà termini, proliferaran CPD preparats per a racks de 50-120 kW , amb solucions de refrigeració i gestió energètica de nova generació. La maduresa del programari seguirà millorant amb integracions fluides i pipelins de quantització automatitzats.
Xarxes i escalabilitat: NVLink 5, switches i fotònica
El teixit dinterconnexió és laltra meitat del rendiment. La 5a generació de NVLink doblega l'amplada de banda i permet unir fins a 576 GPU . Cada enllaç efectiu ofereix ~ 50 GB/s per adreça ; amb 18 enllaços per GPU, l'amplada de banda agregada arriba a ~ 1,8 TB/s , més de 14× que PCIe Gen5.
El commutador NVIDIA NVLink aporta fins a 130 TB/s per domini NVL72, fonamental per a paral·lelisme a escala de model. A més, el suport del protocol SHARP per a reduccions jeràrquiques accelera precisions com a FP8 en operacions col·lectives crítiques.
NVIDIA està empenyent també en xarxes amb Quantum-X800 InfiniBand i Spectrum-X800 Ethernet , amb famílies de switches que van des de 128 a 512 ports de 800G, a més d'opcions de 200G amb alta densitat, i refrigeració líquida integrada per sostenir.
Amb NVIDIA Photonics , els motors òptics integrats al paquet de l'ASIC del switch reemplacen transceptors connectables tradicionals, promovent fins a 3,5× d'eficiència , 10× més resiliència i desplegaments 1,3× més ràpids, aplanant el camí a centres de dades òptics d'alta densitat.
Ecosistema de programari i plataformes: Dynamo, AI‑Q, Mission Control, NIM i OVX
Per esprémer Blackwell, NVIDIA ha presentat diverses peces clau. Dynamo és una plataforma d'inferència de codi obert pensada per escalar una sola consulta entre GPU a través de NVLink, amb millores de fins a 30× en càrregues amb raonament intens com DeepSeek R1 i doblegant throughput a Hopper sense canviar maquinari.
AI‑Q (més AgentIQ) proposa un marc multiagent obert que integra dades empresarials, eines externes i altres agents, facilitant sistemes compostos capaços de raonar sobre text, imatge i vídeo , amb integracions en frameworks com CrewAI, LangGraph o Azure AI Agent Service.
A la capa operativa, Mission Control automatitza l'orquestració end‑to‑end de centres‑de‑dades d'IA, amb commutació fluida entre entrenament i inferència, 5× més utilització i recuperació de treballs 10× més ràpida . A més, Base Command Manager passa a estar disponible sense cost per a fins a vuit acceleradors per sistema.
La pila NVIDIA NIM suma microserveis de IA generativa llestos per a empresa. Per part seva, els sistemes OVX estan orientats a IA generativa i gràfics intensius, acompanyats d'un programa de validació d'emmagatzematge amb DDN, Dell PowerScale, NetApp, Pure Storage o WEKA per garantir throughput i escalat en producció.
Productes per a professionals: RTX Pro Blackwell, DGX Station i DGX Spark
La nova família RTX Pro Blackwell actualitza la línia professional amb fins a 96 GB de memòria a la Pro 6000 i fins a 4.000 TOPS d'IA, nuclis RT de 4a gen i Tensor de 5a gen amb FP4. A Server Edition, afegeix vGPU i MIG per partir una GPU en diverses instàncies aïllades.
En casos reals, s'han reportat 5× en traçat de raigs davant de RTX A6000 (Foster + Partners), fins a 2× en reconstrucció mèdica (GE HealthCare), millores notables en RV (Rivian) i productivitat 3× amb LLM (SoftServe). Pixar destaca que un 3,3% de les preses de producció ja caben en 70 GB d'una sola GPU.
DGX Station s'actualitza amb GB300 Grace Blackwell Ultra, 784 GB de memòria unificada i fins a 20 PFLOPS a IA FP4 , més connectivitat de 800 Gb/s amb ConnectX-8. Per a desenvolupadors i estudiants, DGX Spark amb xip GB10 i 128 GB de memòria unificada ofereix ~1.000 TOPS d'IA i SmartNIC ConnectX‑7, abaratint l'entrada a l'ecosistema.
Exaescala en un rack i superpods a mida
El sistema DGX GB200 NVL72 duplica de 32 a 72 GPU i eleva la memòria des de ~19,5 TB a ~ 30 TB . En còmput, el salt és espectacular: de 127 PF a 1,4 EF a FP4 (~11×), i de 127 PF a 720 PF a FP8 (~5,6×), tot en un xassís completament refrigerat per aigua.
Més amunt, el DGX SuperPOD amb 8 sistemes GB200 NVL72 suma 11,5 exaFLOPS FP4 i 36 SuperChips GB200 per sistema, amb millores de fins a 30× davant H100 en inferència de LLM grans, dissenyat com a “fàbrica de IA” preparada per a models de l'ordre del bili.
En plataforma Grace‑Blackwell, el GB200 enllaça dos B200 amb una CPU Grace compartida via C2C, i escala fins a 576 GPU a 1,8 TB/s mitjançant NVLink 5, acoblant entorns massivament paral·lels adequats per a les càrregues d'IA més exigents.
Quantització moderna: conservar la intel·ligència a 4 bits
L'èxit de FP4 ve de combinar maquinari i programari . L'escalat dual de NVIDIA s'ajusta a la distribució de valors per tensor i el motor Transformer analitza més de 1.000 operacions per optimitzar escales dinàmicament, permetent que models com DeepSeek-R1 arribin al 98,1% de precisió en FP4 i, en alguns tests, superin la línia base FP8.
En postentrenament, SmoothQuant i AWQ han fet possible ficar models de la mida de Falcon 180B en una sola GPU. Si necessites preservar al màxim, el QAT emulant FP4 durant fine-tuning ajuda a adaptar distribucions de pesos. Famílies com Nemotron 4 mostren FP4 sense pèrdues mitjançant QAT, a l'alçada o per sobre de BF16.
Per a casos complicats, la gestió de valors atípics evita col·lapses d'activació i les estratègies de precisió mixta eleven bits en operacions crítiques. El resultat: FP4 és viable en arquitectures denses i també a Mixture of Experts , amb una precisió que no sacrifica producció.
Full de ruta i disponibilitat
Mirant endavant, la generació Vera Rubin apunta a 50 PFLOPS FP4 densos per GPU, amb ConnectX‑9 , NVLink‑6 i memòria HBM4 (+1,6× d'amplada de banda). La interconnexió CPU‑GPU també pujarà fins a ~1,8 TB/s , i Rubin Ultra tornarà a doblegar el llistó fins a 100 PFLOPS FP4 i 1 TB d'HBM4e.
Al costat d'AMD, l'arquitectura CDNA 4 impulsa Matrix Cores amb suport per a FP4 i FP6 , doblant rendiment davant de la generació anterior i afegint sparsity per accelerar encara més, cosa especialment interessant en models Mixture of Experts.
La limitació més immediata no és tècnica sinó de subministrament de maquinari : gran part de la producció B200/B300 de 2025 està compromesa amb hyperscalers. Tot i així, l'impacte en cost per token i eficiència energètica està provocant una democratització real , apropant capacitats d'avantguarda a organitzacions petites gràcies als salts en memòria i còmput per watt.

Contingut
- 1 Què és NVFP4 i en què millora a FP8 i BF16
- 2 Arquitectura Blackwell: el múscul darrere de NVFP4
- 3 Mètriques: més tokens, menys watts i memòria sota control
- 4 Adopció: clouds, empreses i casos reals
- 5 Infraestructura: potència, refrigeració i noves normes del CPD
- 6 Xarxes i escalabilitat: NVLink 5, switches i fotònica
- 7 Ecosistema de programari i plataformes: Dynamo, AI‑Q, Mission Control, NIM i OVX
- 8 Productes per a professionals: RTX Pro Blackwell, DGX Station i DGX Spark
- 9 Exaescala en un rack i superpods a mida
- 10 Quantització moderna: conservar la intel·ligència a 4 bits
- 11 Full de ruta i disponibilitat